Ein SaaS-Projekt startet oft mit einer überschaubaren Idee: Nutzer registrieren sich, buchen ein Paket und verwalten ihre Rechnungen. Anfangs passt die Datenbank scheinbar problemlos dazu. Dann kommen mehrere Tarife, Teams, Rollen, Zahlungen, Exporte und individuelle Einstellungen hinzu. Abfragen werden langsamer, Änderungen an einer Kundentabelle erzeugen unerwartete Nebenwirkungen, und plötzlich ist unklar, welche Daten gelöscht werden müssen, wenn eine Person ihr Konto schließt.
Gutes Database Design verhindert nicht jede technische Schwierigkeit. Es sorgt aber dafür, dass solche Schwierigkeiten sichtbar, prüfbar und lösbar bleiben. Wie bei einem gut geplanten Gebäude entscheidet nicht nur die Fassade, ob ein System dauerhaft funktioniert. Tragwerk, Leitungen, Zugänge und Wartungswege müssen zu den tatsächlichen Anforderungen passen.
Inhaltsverzeichnis
- Warum gutes Database Design über Erfolg entscheidet
- Grundbegriffe im Datenbankdesign verständlich erklärt
- Normalisierung und Denormalisierung richtig abwägen
- Datenmodellierung mit ER-Modellen praxisnah anwenden
- RDBMS und NoSQL sowie Skalierungsmuster gezielt wählen
- Performance optimieren und Migration sicher planen
- DSGVO und Cloud-Betrieb im Datenbankdesign verankern
Warum gutes Database Design über Erfolg entscheidet
Bei einem SaaS-Produkt aus Münster wurde die erste Datenstruktur vermutlich ähnlich aufgebaut wie bei vielen Webprojekten: eine Tabelle für Kunden, eine für Benutzer und eine für Bestellungen. Mit wachsendem Funktionsumfang wanderten Tarifinformationen, Zahlungsstatus und Ansprechpartner in dieselben Datensätze. Für die erste Version war das praktisch. Später musste jede Änderung an einem Unternehmen mehrere Stellen berücksichtigen.
Das Problem lag nicht darin, dass einzelne Entwickler schlechte Arbeit geleistet hatten. Die Datenbank war für den damaligen Anwendungsfall gebaut worden. Der Anwendungsfall hatte sich nur schneller entwickelt als das Modell. Ein sauberer Entwurf hätte früh geklärt, welche Dinge dauerhaft eigenständige Entitäten sind, welche Beziehungen bestehen und welche Informationen aus Datenschutzgründen getrennt behandelt werden müssen.
Die Datenbank als Grundriss
Ein Datenmodell ist wie der Grundriss eines Bürogebäudes. Ein Raum für Besprechungen, ein Raum für Server und ein Raum für vertrauliche Unterlagen erfüllen unterschiedliche Aufgaben. Werden alle Bereiche in einen einzigen Raum gepackt, lässt sich zunächst schnell etwas unterbringen. Im Alltag entstehen jedoch Wege, Konflikte und Sicherheitsprobleme.
Ähnlich trennt ein relationales Modell beispielsweise Unternehmen, Benutzer, Abonnements und Rechnungen. Primärschlüssel identifizieren einzelne Datensätze, Fremdschlüssel verbinden sie, und Constraints verhindern ungültige Zustände. Ein Schema beschreibt dabei die Struktur, nicht die konkreten Daten. Es legt Tabellen, Felder, Beziehungen und Regeln fest.
Das bringt einen geschäftlichen Nutzen:
- Verlässliche Abläufe: Ein Auftrag verweist auf einen gültigen Kunden, statt Kundendaten mehrfach zu kopieren.
- Bessere Erweiterbarkeit: Ein neuer Tarif lässt sich ergänzen, ohne historische Rechnungen umzuschreiben.
- Planbare Integration: CRM, ERP, Zahlungsanbieter und Reporting greifen über definierte Datenbeziehungen auf Informationen zu.
- Beherrschbare Löschung: Personenbezogene Daten können gezielt gefunden, anonymisiert oder entfernt werden.
Praktische Regel: Entwirf nicht für die Oberfläche von heute. Entwirf für die fachlichen Beziehungen, die dein Produkt morgen noch erklären können muss.
Leistung und Compliance gehören zusammen
Bei gemischten OLTP- und OLAP-Workloads beeinflussen Schema- und Designvarianten die Systemleistung unmittelbar. Die an der Universität Potsdam, am HPI und bei SAP entwickelte Benchmark-Studie zeigt, dass transaktionale und analytische Zugriffsmuster unterschiedliche Optimierungsziele verfolgen und ein für OLAP günstiges Design OLTP-Transaktionen verschlechtern kann (Benchmark zu gemischten Datenbank-Workloads).
Auch der deutsche Verwaltungskontext zeigt, wie wichtig eindeutige Identifikatoren und konsolidierte Stammdaten sind. Das Statistische Bundesamt wurde 2021 gesetzlich mit dem zentralen Basisregister für Unternehmen beauftragt, das Unternehmensbasisdatenregistergesetz trat am 15. Juli 2021 in Kraft. Das Register soll Stammdaten aus verschiedenen Registern zusammenführen, eine bundeseinheitliche Wirtschaftsnummer vergeben und das Once-Only-Prinzip unterstützen (Basisregister für Unternehmen beim Statistischen Bundesamt).
Gutes Database Design beantwortet deshalb mehr als die Frage, welche Tabelle eine Webmaske braucht. Es klärt, wo Daten entstehen, wer sie ändern darf, wie sie ausgewertet werden und wie ein Unternehmen seine regulatorischen Pflichten im laufenden Betrieb erfüllt.
Grundbegriffe im Datenbankdesign verständlich erklärt
Wer eine Datenbank plant, sollte zunächst zwischen Datenbank und Schema unterscheiden. Die Datenbank enthält die gespeicherten Informationen. Das Schema ist der Bauplan dafür, wie Tabellen, Felder, Beziehungen und Regeln organisiert sind. Diese Trennung hilft, Anforderungen zu diskutieren, bevor konkrete Datensätze oder Frameworks die Sicht verengen.
Eine Entität ist ein fachliches Ding, über das das System Informationen speichert. In einem SaaS-Produkt können das ein Unternehmen, ein Benutzer, ein Abonnement oder eine Rechnung sein. Die Eigenschaften dieser Entität heißen Attribute, etwa Name, E-Mail-Adresse, Startdatum oder Status.
Eine Tabelle ist kein Sammelbehälter für alles, was irgendwie zusammengehört. Sie sollte eine fachliche Einheit klar beschreiben.
Schlüssel schaffen Ordnung
Jede Zeile braucht eine eindeutige Identität. Dafür dient der Primärschlüssel, beispielsweise customer_id. Er muss nicht aus einem sichtbaren Namen bestehen. Namen können sich ändern und sind nicht immer eindeutig. Eine technische ID bleibt dagegen stabil und eignet sich für Beziehungen.
Ein Fremdschlüssel verweist auf den Primärschlüssel einer anderen Tabelle. Eine Rechnung kann etwa auf ein Unternehmen zeigen, während eine Zuordnungstabelle festhält, welche Benutzer zu welchem Unternehmen gehören. Bei einer Viele-zu-Viele-Beziehung entsteht häufig genau so eine Zwischentabelle.
Die wichtigsten Beziehungstypen lassen sich mit Alltagssituationen erklären:
- Eins zu eins: Ein Benutzer besitzt ein persönliches Profil.
- Eins zu viele: Ein Unternehmen hat mehrere Rechnungen.
- Viele zu viele: Mehrere Benutzer arbeiten in mehreren Projekten mit.
Constraints sind eingebaute Regeln
Ein Datenbankentwurf sollte ungültige Zustände möglichst dort verhindern, wo sie entstehen. NOT NULL verlangt einen Wert, UNIQUE verhindert doppelte Einträge, CHECK begrenzt erlaubte Zustände, und DEFAULT setzt einen definierten Anfangswert. Ein Rechnungsstatus darf dann nicht beliebige Schreibweisen wie „offen“, „Open“ und „bezahlt?“ gleichzeitig enthalten.
Indizes beschleunigen häufige Such- und Verknüpfungsvorgänge. Sie sind jedoch kein kostenloser Turbo. Jeder zusätzliche Index muss bei Änderungen gepflegt werden und benötigt Speicher. Deshalb gehören Abfrageprofile und erwartete Schreiblast zur Modellierung, nicht erst zur Fehlersuche.
Eine View kann komplexe Joins für Reporting oder interne Oberflächen lesbarer machen, ohne die zugrunde liegenden Tabellen zu kopieren. Für den Entwurf helfen Werkzeuge wie dbdiagram.io, DrawSQL, Lucidchart, MySQL Workbench, pgAdmin, Flyway und Liquibase. Das Werkzeug ersetzt aber keine fachliche Entscheidung. Vor dem produktiven Einsatz sollte mindestens eine weitere Person Tabellen, Beziehungen und Constraints prüfen.
Normalisierung und Denormalisierung richtig abwägen
Normalisierung reduziert doppelte Informationen und verhindert, dass eine Änderung an einer Stelle vergessen wird. In einem Webshop gehören Produktname und Produktbeschreibung in die Produkttabelle. Eine Bestellung verweist über Bestellpositionen auf Produkte und speichert zusätzlich den damals gültigen Verkaufspreis, weil sich der aktuelle Produktpreis später ändern kann.
Die klassischen Normalformen liefern dabei eine hilfreiche Orientierung. In der ersten Normalform enthält jedes Feld einen einzelnen, atomaren Wert. Die zweite Normalform verlangt, dass Nichtschlüsselattribute vom gesamten Primärschlüssel abhängen. In der dritten Normalform soll ein Nichtschlüsselattribut nicht von einem anderen Nichtschlüsselattribut abhängen.
Das ist kein Selbstzweck. Ein normalisiertes Modell verhindert beispielsweise, dass eine Adressänderung in mehreren Bestellungen dieselbe Kundendatenkopie korrigieren muss. Es macht Beziehungen explizit und erleichtert Transaktionen, Validierung und Wartung.
Zwei Modelle für zwei Zugriffsmuster
Ein Reporting-Dashboard stellt andere Anforderungen als der Checkout. Der Checkout schreibt Bestellungen, reserviert Bestand und muss konsistente Zustände erzeugen. Ein Dashboard liest dagegen häufig aggregierte Werte über viele Datensätze. Ein Schema, das den einen Zugriff optimal unterstützt, kann den anderen komplizierter machen.
| Kriterium | Normalisiert | Denormalisiert |
|---|---|---|
| Datenredundanz | Geringer, Informationen liegen möglichst einmal vor | Höher, ausgewählte Werte werden bewusst wiederholt |
| Änderungen | Konsistent und meist zentral steuerbar | Mehrere Stellen müssen synchron gehalten werden |
| Joins | Häufiger erforderlich | Weniger Joins bei vorbereiteten Lesezugriffen |
| Transaktionen | Geeignet für klar getrennte Schreibvorgänge | Kann bei vielen Schreibpfaden zusätzlichen Aufwand erzeugen |
| Reporting | Flexibel, aber oft komplexer | Lesbare und schnelle Auswertung bestimmter Fragestellungen |
| Betrieb | Einfacher zu erklären und zu validieren | Zusätzliche Synchronisierung und Überwachung nötig |
Denormalisierung kann sinnvoll sein, wenn ein Leseweg besonders häufig oder fachlich stabil ist. Ein SaaS-Reporting könnte etwa eine vorbereitete Kennzahlentabelle nutzen, während die transaktionalen Stammtabellen normalisiert bleiben. Entscheidend ist, dass die Quelle der Wahrheit festgelegt wird und klar ist, wann abgeleitete Werte aktualisiert werden.
Eine nüchterne Entscheidungshilfe
Frage vor einer Denormalisierung:
- Welche Abfrage ist langsam, und warum?
- Ist die Ursache ein schlechtes Indexdesign, ein ungünstiger Query-Plan oder tatsächlich zu viele Joins?
- Wie oft ändern sich die kopierten Werte?
- Muss die Auswertung aktuell sein, oder reicht eine kontrollierte Aktualisierung?
- Wer bemerkt eine fehlerhafte Synchronisierung?
- Wie lässt sich der abgeleitete Datensatz neu aufbauen?
Eine an der Universität Mannheim und der Universität Passau durchgeführte Untersuchung zeigte in einem TPC-D-basierten Experiment, dass leichte Kompression die Antwortzeiten IO-intensiver Abfragen um bis zu 50 Prozent senken kann, während bestimmte Updates langsamer werden können (Experiment zu Kompression bei Datenbanken). Das Prinzip ähnelt der Denormalisierung: Lesezugriffe können profitieren, während Änderungen zusätzliche Kosten verursachen. Historisierte und selten veränderte Analysedaten eignen sich eher dafür als stark transaktionale Tabellen.
Datenmodellierung mit ER-Modellen praxisnah anwenden
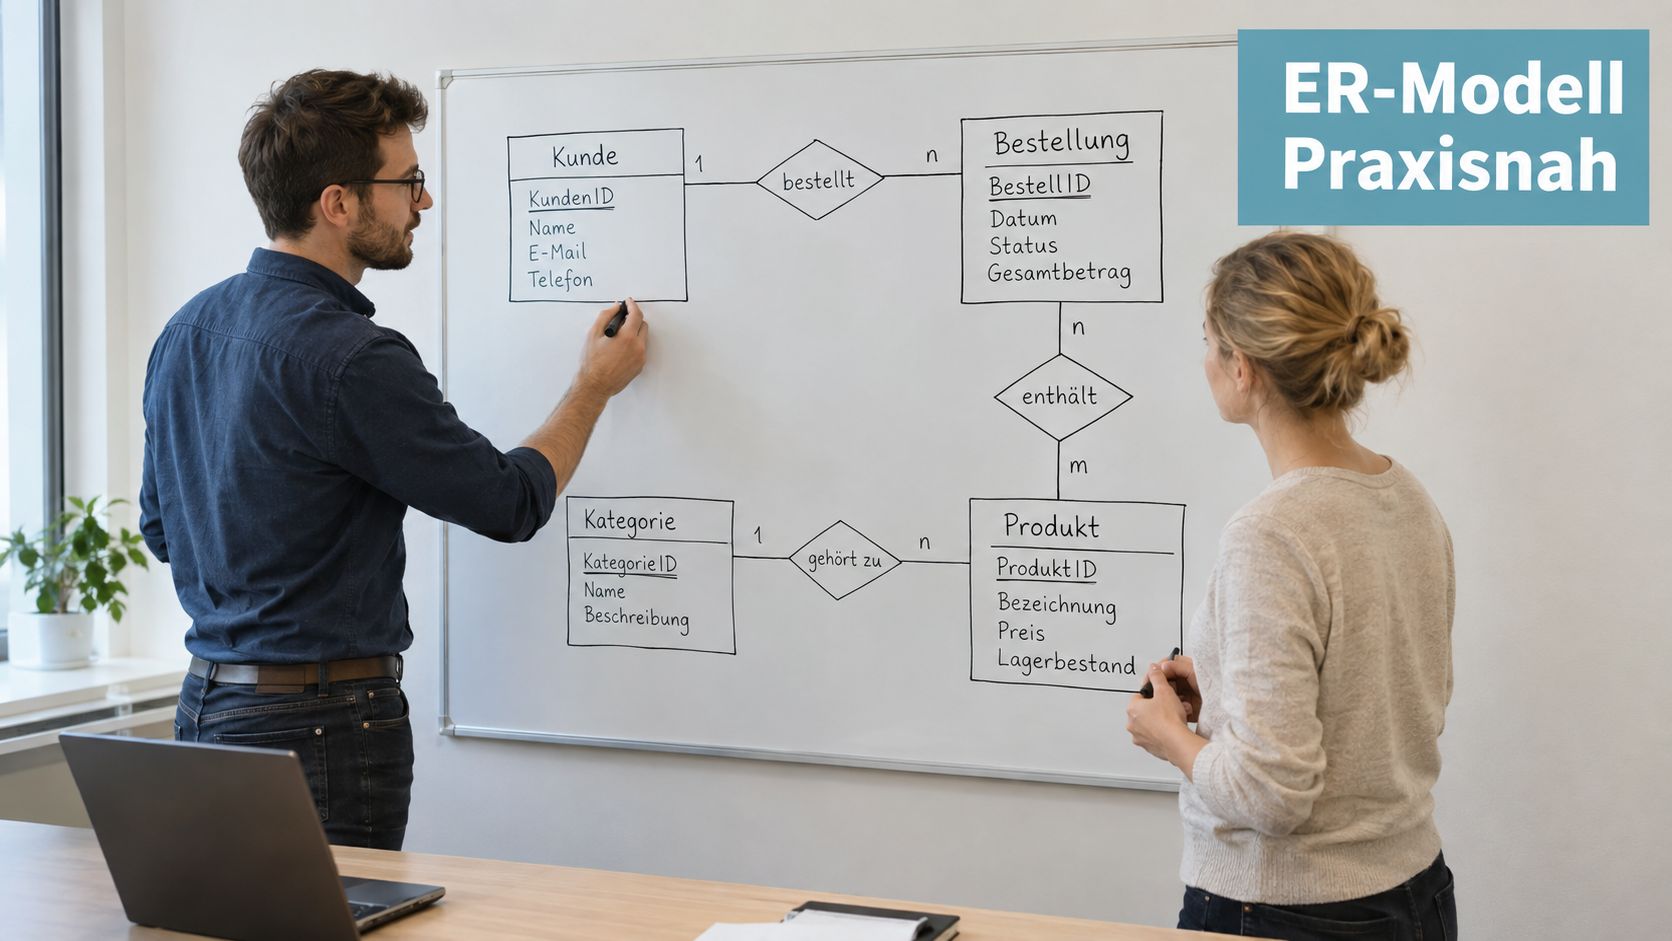
Ein ER-Modell übersetzt fachliche Anforderungen in Entitäten und Beziehungen. Es ist besonders nützlich, bevor Tabellen und Migrationen entstehen. Ein Workshop beginnt deshalb nicht mit der Frage, ob PostgreSQL oder eine NoSQL-Datenbank eingesetzt wird, sondern mit Sätzen wie: „Ein Unternehmen kann mehrere Abonnements haben“ oder „Eine Rechnung gehört genau zu einem Abonnement.“
Vom Fachsatz zum Modell
Für ein SaaS-Tool mit Teamverwaltung kann die Modellierung schrittweise erfolgen:
- Entitäten sammeln: Unternehmen, Benutzer, Abonnement, Tarif und Rechnung.
- Attribute zuordnen: Ein Abonnement erhält Startdatum, Enddatum und Status. Ein Tarif erhält Bezeichnung und Leistungsumfang.
- Beziehungen formulieren: Ein Unternehmen besitzt Benutzerkonten. Ein Unternehmen kann Abonnements wechseln. Ein Abonnement verweist auf einen Tarif.
- Kardinalitäten prüfen: Eine Rechnung gehört zu einem Abonnement, ein Abonnement kann mehrere Rechnungen erzeugen.
- Regeln ergänzen: Ein Status darf nur definierte Werte enthalten. Ein Abonnement ohne Unternehmen ist ungültig.
- Lebenszyklen klären: Was passiert mit Rechnungen, wenn ein Benutzer gelöscht wird? Welche Datensätze müssen erhalten bleiben?
Das konzeptionelle Modell beschreibt die Fachlichkeit ohne technische Details. Im logischen Modell kommen Tabellen, Schlüssel und Datentypen hinzu. Das physische Modell entscheidet anschließend über konkrete Indizes, Partitionierung, Speicheroptionen und Datenbankfunktionen.
Ein brauchbares Modell entsteht iterativ. Product Owner, Support und Buchhaltung kennen oft Regeln, die im Ticket-System nicht dokumentiert sind. Ein kurzer Abgleich kann aufdecken, dass „Benutzer löschen“ in Wirklichkeit nur den Zugang sperrt, während abrechnungsrelevante Vorgänge erhalten bleiben müssen.
Ein möglicher ER-Ausschnitt lässt sich so lesen:
- Unternehmen verbindet sich mit vielen Benutzern.
- Benutzer und Rollen werden über eine Zuordnung verbunden.
- Unternehmen besitzt ein oder mehrere Abonnements.
- Abonnement verweist auf einen Tarif und erzeugt Rechnungen.
- Rechnung enthält den fachlich erforderlichen Status und einen nachvollziehbaren Zeitbezug.
Zeichne zuerst die Beziehung, die in einem Kundengespräch vorkommt. Wenn das Modell diesen Satz nicht klar ausdrücken kann, ist es noch nicht fertig.
Nach der fachlichen Prüfung werden Testfälle formuliert. Dazu gehören ein neues Unternehmen, ein Tarifwechsel, eine fehlgeschlagene Zahlung, die Einladung eines Benutzers und die Beendigung eines Abonnements. Jede Situation sollte zeigen, welche Zeilen entstehen, geändert werden oder bewusst erhalten bleiben.
Eine kompakte Einführung in die visuelle Modellierung und relationale Datenbanken bietet auch dieses ergänzende Video:
RDBMS und NoSQL sowie Skalierungsmuster gezielt wählen
Die Datenbanktechnologie sollte dem Zugriffsmuster folgen, nicht der Mode. Ein relationales Datenbankmanagementsystem wie PostgreSQL oder MySQL passt gut, wenn Beziehungen, Transaktionen und konsistente Zustände im Mittelpunkt stehen. Ein SaaS-Checkout mit Abonnements, Rechnungen und Rollen profitiert meist von klaren Fremdschlüsseln und atomaren Änderungen.
NoSQL ist kein pauschaler Ersatz. Dokumentdatenbanken können sinnvoll sein, wenn Datensätze stark unterschiedlich aufgebaut sind oder eine Anwendung vollständige Dokumente gemeinsam liest und schreibt. Schlüssel-Wert-Speicher eignen sich für kurzlebige Sitzungsdaten und Caches. Für Graphdatenbanken sprechen Beziehungen, deren Traversierung selbst die zentrale Abfrage ist.
Die Auswahl anhand konkreter Fragen
| Frage | Relationales System | NoSQL-System |
|---|---|---|
| Beziehungen | Starke Modellierung mit Fremdschlüsseln und Joins | Beziehungen werden je nach Typ eingebettet, referenziert oder separat gepflegt |
| Schema | Strukturiert und explizit | Häufig flexibler, aber weiterhin dokumentationsbedürftig |
| Transaktionen | Zentraler Anwendungsfall | Abhängig vom Produkt und dem gewählten Datenmodell |
| Auswertung | SQL und relationale Aggregationen | Oft auf konkrete Zugriffsmuster zugeschnitten |
| Geeigneter SaaS-Fall | Abrechnung, Benutzerrechte, Stammdaten | Ereignisdaten, variable Dokumente, spezialisierte Lesezugriffe |
Auch innerhalb einer relationalen Plattform können unterschiedliche Modelle nebeneinander bestehen. Ein operatives Schema speichert Geschäftsvorgänge. Eine getrennte Analyseprojektion bereitet Daten für BI und Reporting auf. Dadurch muss das transaktionale Modell nicht jede analytische Fragestellung direkt bedienen.
Skalierung ist mehr als größere Hardware
Vertikale Skalierung gibt einem bestehenden System mehr CPU, Arbeitsspeicher oder Storage. Sie ist oft der einfachste erste Schritt, hat aber Grenzen. Horizontale Skalierung verteilt Last auf mehrere Instanzen und verlangt zusätzliche Entscheidungen zu Replikation, Konsistenz und Fehlerbehandlung.
Eine Read Replica kann Lesezugriffe entlasten, darf aber nicht automatisch als sofort aktuelle Quelle behandelt werden. Sharding verteilt Datensätze nach einem Schlüssel, etwa nach Mandant. Das kann bei Multi-Tenant-SaaS helfen, erschwert jedoch globale Auswertungen und spätere Mandantenverschiebungen.
Caching reduziert wiederholte Zugriffe auf langsamere oder stärker belastete Schichten. Es braucht aber klare Regeln für Ablauf, Invalidierung und sensible Inhalte. Ein Cache mit veralteten Berechtigungen ist kein reines Performanceproblem, sondern kann ein Sicherheitsrisiko werden.
Für unabhängige Entscheidungen zu Datenmodell, Hosting und Integration kann eine Software-Architektur-Beratung in Münster und NRW sinnvoll sein. Dabei sollte der Dienstleister nicht nur die Datenbank nennen, sondern den gesamten Zugriffspfad erklären, vom Browser über die Anwendung bis zum Reporting.
Performance optimieren und Migration sicher planen
Performanceprobleme beginnen selten mit einem einzigen fehlenden Index. Häufig kombiniert sich ein unpassender Query-Plan mit zu großen Ergebnismengen, unnötigen Joins oder einer Datenstruktur, die Schreib- und Lesezugriffe vermischt. Eine belastbare Analyse startet deshalb mit realen Abfragen, ihren Laufplänen und dem tatsächlichen Workload.
Ein Index auf customer_id kann eine Verknüpfung beschleunigen. Ein zusammengesetzter Index muss dagegen zur Filter- und Sortierreihenfolge der Abfrage passen. Zu viele Indizes erhöhen den Aufwand bei Inserts und Updates. Partitionierung kann historische Daten logisch trennen, bringt aber zusätzliche Betriebsregeln und sollte nicht als Ersatz für ein klares Modell dienen.
Messbare Hebel ohne blinde Optimierung
Ein sinnvolles Vorgehen sieht so aus:
- Abfragen beobachten: Langsame Abfragen, hohe Lock-Wartezeiten und ungewöhnliche Lastspitzen sammeln.
- Plan prüfen: Sehen, ob die Datenbank einen Index verwendet oder große Bereiche vollständig scannt.
- Datenmenge begrenzen: Nur benötigte Spalten und Datensätze lesen, statt komplette Tabellen in die Anwendung zu übertragen.
- Schreibpfad testen: Jede Optimierung gegen Inserts, Updates und konkurrierende Transaktionen prüfen.
- Historie trennen: Alte, selten veränderte Daten gegebenenfalls partitionieren oder für Analysen komprimieren.
Die erwähnte Kompressionsuntersuchung zeigt den grundlegenden Zielkonflikt: Weniger IO kann leseintensive Abfragen beschleunigen, während Änderungen durch zusätzliche Verarbeitung langsamer werden können. Deshalb sollten Teams nicht nur die schnellste Einzelabfrage messen, sondern ein repräsentatives Verhältnis aus Schreiblast, Einzelzugriffen und Reporting abbilden.
Migration mit kontrollierter Umschaltung
Eine Migration im laufenden SaaS-Betrieb braucht mehr als ein Skript. Zuerst werden Quellfelder und Zielfelder gemappt. Danach folgen Bereinigung, Validierung und ein Probelauf mit anonymisierten oder kontrollierten Daten. Besonders kritisch sind Zeitzonen, Zeichensätze, Statuswerte, fehlende Fremdschlüssel und historische Beträge.
Bei einer Zero-Downtime-Strategie läuft die alte Datenbank zunächst weiter. Änderungen werden parallel in die neue Struktur übertragen, während die neue Anwendung mit Testdaten geprüft wird. Erst wenn Zählungen, Beziehungen, Geschäftsprozesse und Rückfallplan stimmen, erfolgt die Umschaltung. Für den Notfall muss klar sein, ob und wie neue Änderungen zurück in das alte System gelangen.
IT-Integrationen und Migrationen für SaaS in Münster und NRW verbinden diese technische Arbeit mit den betroffenen Fachsystemen. Das ist entscheidend, weil CRM, ERP, Zahlungsdienst und Analyseplattform dieselbe fachliche Bedeutung eines Datensatzes unterschiedlich abbilden können.
DSGVO und Cloud-Betrieb im Datenbankdesign verankern
Datenschutz lässt sich nicht nachträglich an eine fertige Datenbank ankleben. Schon beim Modellieren muss feststehen, welche Informationen personenbezogen sind, aus welcher Quelle sie kommen, wer sie lesen darf und wie lange sie benötigt werden. Ein Dateninventar und eine Datenflusskarte zeigen, ob eine E-Mail-Adresse nur im Benutzerkonto oder zusätzlich in Logs, Backups, Suchindizes und Analyseprojektionen auftaucht.
Die zentrale Frage lautet nicht nur, ob eine Tabelle normalisiert ist. Sie lautet: Kann das Unternehmen eine Löschanfrage, eine Consent-Änderung und einen Datenexport über alle verteilten Systeme nachvollziehbar umsetzen? Eine deutschsprachige Übersicht zur DSGVO-Architektur und Datenschutz in der Cloud ordnet Consent-Management, Dateninventare und verteilte Löschbarkeit als zentrale Architekturthemen ein.
Löschung und Zugriff im Schema
Für SaaS-Produkte sollten Lösch- und Aufbewahrungsregeln je Entität dokumentiert werden. Manche Datensätze müssen gelöscht werden, andere werden anonymisiert, und wieder andere bleiben aus rechtlichen oder betrieblichen Gründen erhalten. Diese Entscheidung darf nicht allein vom ORM oder von einem einzelnen DELETE abhängen.
Rollen und Rechte sollten den tatsächlichen Aufgaben entsprechen. Anwendung, Support, Reporting und Datenbankadministration brauchen nicht automatisch denselben Zugriff. Verschlüsselung, getrennte Schlüsselverwaltung, Audit-Logs sowie getestete Backup- und Recovery-Verfahren gehören deshalb zum Betriebsdesign.
Der BSI veröffentlichte 2025 neue Sicherheitsanforderungen für Datenbanksysteme und macht damit deutlich, dass Datenbanksicherheit im deutschen Kontext stärker als eigenständiges Auswahl- und Architekturthema behandelt wird (BSI zu Sicherheitsanforderungen für Datenbanksysteme). Eine Cloud-Datenbank ist nicht automatisch DSGVO-konform. Standort, Auftragsverarbeitung, Schlüsselzugriff, Protokollierung und Wiederherstellung müssen konkret geprüft werden.
EU-Only und praktische Betriebsfähigkeit
Bei einer Migration in eine EU-only Cloud sollte das Team Daten, Schlüssel, Backups, Monitoring und Supportzugriffe gemeinsam betrachten. Eine Datenbank in der EU genügt nicht, wenn Sicherungen oder Diagnoseinformationen an anderer Stelle landen. Für Unternehmen, die eine souveräne Alternative mit deutschem Betrieb prüfen, bietet eine souveräne Cloud-Alternative mit Nextcloud Workspace aus Deutschland einen möglichen Ausgangspunkt für die Architekturprüfung.
Ein Praxisfall wie ORM-Center.de zeigt, warum SaaS-Datenmodelle Produktlogik, Mandantentrennung und Datenschutz zusammenführen müssen. Bei EU-only-Migrationen kommen zusätzlich Datenflüsse, Schlüsselverwaltung und Rückfallprozesse hinzu. Der EU Data Act gilt seit 12. September 2025 parallel zur DSGVO und beeinflusst damit auch Fragen zu Datenzugang, Datennutzung, Aufbewahrung und Zugriffskontrolle (Einordnung von DSGVO und Cloud-Datenschutz).
Prüfe dein aktuelles Datenmodell jetzt anhand eines echten Geschäftsprozesses. Wähle eine Funktion wie Registrierung, Tarifwechsel oder Löschung, zeichne alle beteiligten Tabellen und Systeme auf und dokumentiere anschließend fehlende Constraints, unklare Verantwortlichkeiten sowie nicht getestete Backup- und Löschpfade. Wenn daraus konkrete Architektur- oder Migrationsfragen entstehen, lass das Modell vor der nächsten Produktphase von einem erfahrenen Web- und SaaS-Team überprüfen.